Evoluzione delle architetture LLM
-
Denis Dal Molin
- 31 Jul, 2026
- 27 Mins read

Questo articolo ha uno scopo divulgativo. Pur trattando concetti che derivano dalla ricerca e dall'ingegneria degli LLM, ho scelto di privilegiare la comprensione rispetto al formalismo matematico e ai dettagli implementativi.
Alcuni meccanismi sono quindi descritti in modo semplificato per rendere l'evoluzione delle architetture accessibile anche a chi non ha un background specifico. Quando necessario, vengono introdotte alcune semplificazioni concettuali che non alterano l'idea di fondo, ma evitano di appesantire la lettura.
Negli ultimi anni l'evoluzione degli LLM è stata raccontata soprattutto attraverso nuovi modelli.
Dietro ogni innovazione, però, si nasconde quasi sempre la risposta ad un problema preciso: aumentare la capacità di rappresentazione, ridurre il costo computazionale, superare i limiti della memoria o migliorare il ragionamento.
Ogni volta che compare un nuovo modello è facile concentrarsi sulle sue prestazioni, sul numero di parametri o sui benchmark pubblicati.
"Quanto è migliore del precedente?"
È un approccio naturale, ma spesso porta a vedere ogni innovazione come un evento isolato.
In realtà, l'evoluzione delle architetture per gli LLM è molto più simile a una lunga catena di decisioni ingegneristiche. Ogni nuova generazione nasce perché quella precedente ha raggiunto un limite.
Comprendere questa sequenza significa acquisire un modello mentale. Le architetture cambiano rapidamente, ma i problemi che cercano di risolvere sono ricorrenti.

Prima dei Transformer
La storia degli LLM non inizia con ChatGPT, né con il Transformer.
Le sue radici affondano nelle prime reti neurali, sviluppate molti decenni prima.
Ogni passaggio evolutivo ha introdotto un miglioramento significativo, ma ha anche evidenziato nuovi limiti che hanno spinto la ricerca verso architetture differenti.
Perceptron: il primo neurone artificiale
Il Perceptron, proposto da Frank Rosenblatt nel 1958, rappresenta uno dei primi modelli di neurone artificiale. L'idea è semplice: ricevere un insieme di input, combinarli attraverso pesi appresi durante l'addestramento e produrre un'uscita.
Dal punto di vista storico è un passaggio importante, perché introduce il concetto di apprendimento automatico attraverso l'aggiornamento dei pesi.
Tuttavia, il modello presenta un limite: può apprendere soltanto problemi linearmente separabili.
Questo significa che non è in grado di rappresentare relazioni più complesse tra gli input, rendendolo inadatto alla maggior parte dei problemi reali. Quel limite diventerà il punto di partenza della generazione successiva.
Multilayer Perceptron: introdurre la profondità
Per superare i limiti del Perceptron vengono introdotte reti con più livelli nascosti, note come Multi Layer Perceptron (MLP).
L'aggiunta di livelli intermedi e funzioni di attivazione non lineari consente finalmente di modellare relazioni molto più complesse.
Gli MLP introducono l'idea di reti profonde, che molti anni più tardi darà origine al moderno Deep Learning. Invece di imparare soltanto una trasformazione lineare, la rete costruisce rappresentazioni sempre più astratte dei dati man mano che attraversa i vari strati.
Per molti anni gli MLP hanno rappresentato la base della maggior parte delle applicazioni di machine learning. Esisteva però un nuovo problema, gli MLP trattano ogni input come indipendente dagli altri.
Per immagini questo limite è parzialmente accettabile, ma nel linguaggio naturale l'ordine delle parole è fondamentale. Una rete che ignora la sequenza non può comprenderne il significato.
L'aumento della profondità introduce però anche una nuova sfida: come addestrare efficacemente reti composte da molti layer?
Backpropagation: imparare dai propri errori
Una rete neurale apprende modificando progressivamente i propri pesi e per poterlo fare deve conoscere quanto ciascun parametro abbia contribuito all'errore finale.
Dopo aver calcolato l'errore in uscita, l'informazione viene propagata all'indietro attraverso tutti i layer della rete, permettendo di aggiornare ogni peso in proporzione al proprio contributo.
In pratica, la rete capisce anche dove ha sbagliato.
CNN: riconoscere i pattern
Le Convolutional Neural Network (CNN) introdussero un'idea completamente diversa.
Invece di collegare ogni neurone a tutti gli ingressi, utilizzavano piccoli filtri convoluzionali capaci di individuare pattern locali, come bordi, angoli e texture.
Procedendo attraverso i vari strati queste caratteristiche elementari venivano progressivamente combinate fino a rappresentare oggetti sempre più complessi.
Le CNN hanno rivoluzionato la computer vision e introdotto un principio destinato a influenzare la ricerca successiva, costruire rappresentazioni gerarchiche dei dati invece di analizzarli direttamente nella loro forma originale.
RNN: le reti ricorrenti
Le Recurrent Neural Network (RNN) nascono proprio per affrontare questo problema.
Invece di elaborare ogni elemento in modo indipendente, la rete mantiene uno stato che viene aggiornato a ogni passo della sequenza. In questo modo ogni parola viene interpretata anche alla luce delle informazioni elaborate in precedenza. Per la prima volta le reti neurali introducono uno stato interno ricorrente che permette di propagare informazioni lungo una sequenza.
Le RNN non "ricordano" realmente tutto il passato. Lo comprimono progressivamente in uno stato nascosto di dimensione fissa. Più la sequenza cresce, più diventa difficile preservare le informazioni realmente importanti.
Questo rappresenta un enorme passo avanti per il Natural Language Processing.
Le RNN permettono infatti di affrontare attività come:
- traduzione automatica;
- riconoscimento vocale;
- generazione di testo;
- analisi del sentiment.
Ma anche questa soluzione introduceva un nuovo limite.
LSTM e GRU: migliorare la memoria
Quando le sequenze diventano lunghe, le RNN iniziano a soffrire del cosiddetto vanishing gradient.
Durante l'addestramento i gradienti associati agli elementi più lontani tendono progressivamente ad attenuarsi, rendendo sempre più difficile aggiornare correttamente i pesi responsabili delle dipendenze a lungo termine.
Per mitigare questo problema vengono introdotte le Long Short-Term Memory (LSTM) e, successivamente, le Gated Recurrent Unit (GRU). Entrambe introducono meccanismi di gating che regolano quali informazioni conservare, aggiornare o eliminare. Rispetto alle RNN tradizionali offrono una memoria molto più stabile e consentono di gestire sequenze significativamente più lunghe.
Eppure continuano ad avere un limite strutturale. L'elaborazione rimane intrinsecamente sequenziale, ogni parola dipende dal calcolo della precedente e questo impedisce un parallelismo efficace sulle moderne GPU rendendo l'addestramento sempre più costoso all'aumentare della lunghezza delle sequenze.

La rivoluzione Transformer
Nel 2017 il paper Attention Is All You Need introduce un'idea destinata a cambiare radicalmente il mondo dell'intelligenza artificiale. Invece di elaborare le parole una alla volta, durante l'addestramento può elaborare l'intera sequenza in parallelo, sfruttando in modo più efficiente l'hardware moderno e riducendo i tempi di di addestramento, anche se durante la generazione autoregressiva deve comunque produrre un token alla volta.
Ma il vero elemento rivoluzionario è l'introduzione del meccanismo di Self-Attention. Per la prima volta ogni token può valutare direttamente quanto siano rilevanti tutti gli altri token della sequenza, indipendentemente dalla loro distanza.
Informazioni che nelle RNN richiedevano decine o centinaia di passaggi possono ora essere messe in relazione in un'unica operazione. Questo permette al modello di costruire rappresentazioni contestuali molto più ricche e di catturare dipendenze a lungo raggio con un'efficacia mai vista prima.
È un nuovo modo di rappresentare il linguaggio.
Ed è proprio da questa intuizione che nasceranno tutti i moderni Large Language Model.

Tokenizzazione
Per un essere umano le parole hanno un significato immediato, per un modello invece una parola è semplicemente una sequenza di caratteri. Prima di poter elaborare il linguaggio, deve trasformarlo in una rappresentazione numerica. Il primo passo consiste nella tokenizzazione.
Un testo viene suddiviso in unità elementari, chiamate token, che possono rappresentare parole intere, parti di parole o persino singoli caratteri, a seconda del tokenizer utilizzato.
Ad esempio, la frase:
The architecture scales efficiently.
potrebbe essere rappresentata come una sequenza di token simile a:
["The", " architecture", " scales", " efficiently", "."]
Ogni token viene quindi convertito in un identificatore numerico.
Ma un semplice numero non contiene alcuna informazione semantica.
Per questo motivo entra in gioco il passo successivo.
Dagli identificatori agli embedding
Gli embedding trasformano ogni token in un vettore numerico ad alta dimensionalità.
Possiamo immaginarli come coordinate in uno spazio geometrico in cui parole con significati simili tendono a occupare regioni vicine.
Ad esempio, termini come:
- GPU
- CPU
- TPU
avranno rappresentazioni molto più vicine tra loro rispetto a parole come:
- banana
- montagna
- pianoforte
Naturalmente questa vicinanza non deriva dal significato "umano" delle parole, ma emerge durante l'addestramento osservando miliardi di esempi.
Gli embedding costituiscono il primo livello di comprensione del linguaggio.
Un embedding non rappresenta il significato assoluto di una parola, ma il modo in cui quella parola viene utilizzata nel contesto dei dati di addestramento. Per questo motivo può cambiare nel corso dell'addestramento e differire tra modelli diversi.
Spazio vettoriale e spazio latente
In molti articoli questi due termini vengono utilizzati come sinonimi quando in realtà indicano concetti leggermente diversi.
- Lo spazio vettoriale è l'ambiente matematico in cui ogni embedding viene rappresentato come un vettore di numeri.
- Lo spazio latente, invece, rappresenta il livello di rappresentazione interna costruito dalla rete durante l'elaborazione.
Potremmo dire che gli embedding costituiscono il punto di ingresso nello spazio delle rappresentazioni vettoriali, mentre ogni layer del Transformer costruisce progressivamente rappresentazioni sempre più astratte nello spazio latente.
Questa distinzione è importante perché molte delle tecniche più recenti intervengono proprio sulle rappresentazioni latenti per migliorare l'efficienza dei modelli.
Positional Encoding
Immaginiamo due frasi:
- Il cloud accelera l'AI
- L'AI accelera il cloud
Gli embedding delle singole parole sono praticamente identici, eppure il significato complessivo cambia completamente.
Il Transformer, elaborando tutti i token contemporaneamente, perde infatti qualsiasi informazione sull'ordine con cui essi compaiono nella frase.
Era necessario introdurre un meccanismo capace di rappresentare la posizione di ogni token.
La prima soluzione proposta consiste nell'aggiungere a ogni embedding un vettore che rappresenta la sua posizione all'interno della sequenza, così facendo il modello non conosce soltanto il significato dei token, ma anche la loro collocazione relativa. Questo semplice accorgimento permette di distinguere frasi che contengono le stesse parole ma in ordine differente.
Con l'aumento della lunghezza dei contesti, però, hanno iniziato a emergere alcuni limiti.
RoPE: rappresentare le relazioni
L'introduzione del Rotary Positional Embedding (RoPE) rappresenta un cambiamento concettuale. Invece di memorizzare una posizione assoluta, rende la Self-Attention sensibile alle posizioni relative attraverso una rotazione delle rappresentazioni Query e Key. Questo approccio consente al modello di generalizzare meglio anche su sequenze molto più lunghe rispetto a quelle viste durante l'addestramento.
È uno dei fattori che hanno facilitato l'estensione delle finestre contestuali moderne.
Self-Attention: il cuore del Transformer
Le reti ricorrenti cercavano di ricordare il passato.
Il Transformer adotta un approccio completamente diverso. Ogni token osserva direttamente tutti gli altri token della sequenza e decide autonomamente quali siano realmente importanti.

In pratica, quando il modello elabora una parola, costruisce dinamicamente una mappa delle relazioni con tutto il contesto disponibile.
Questa è la Self-Attention.
Non importa quanto due parole siano lontane nella frase, possono comunque influenzarsi direttamente. È proprio questa capacità che rende i Transformer così efficaci nella comprensione del linguaggio naturale.
La Self-Attention possiede però una caratteristica poco evidente, ogni token deve confrontarsi con tutti gli altri token. Se la sequenza contiene N token, la matrice di attenzione ha complessità O(N²) in tempo e memoria. Per contesti ridotti questo non rappresenta un problema.
Quando però si passa da poche centinaia a decine di migliaia di token, il costo computazionale e il consumo di memoria crescono rapidamente.
È il primo grande collo di bottiglia che accompagnerà tutta l'evoluzione successiva degli LLM.
Il successo dei Transformer ha spostato il problema. Le RNN erano limitate dal calcolo sequenziale; i Transformer sono limitati dalla crescita quadratica dell'attenzione e dal traffico verso la memoria.

Come decide a cosa prestare attenzione?
Il termine Attention non è casuale. Il modello non considera tutti i token con la stessa importanza.
Per ogni token calcola un insieme di punteggi che rappresentano quanto gli altri elementi della sequenza siano rilevanti per comprenderne il significato. Questi punteggi vengono poi utilizzati per costruire una somma pesata delle informazioni disponibili.
In pratica, il modello attribuisce automaticamente maggiore importanza ai token che ritiene più significativi e riduce l'influenza di quelli meno utili in quel particolare contesto.
Non segue regole predefinite, impara autonomamente dove concentrare la propria attenzione.
Le autostrade dell'apprendimento (ResNet)
Prima di osservare l'interno di un layer Transformer è utile introdurre una delle idee più importanti che l'architettura eredita dal Deep Learning moderno: le Residual Connections.
Quando le reti neurali diventano molto profonde emerge infatti un problema inatteso. In teoria aggiungere layer dovrebbe migliorare continuamente le prestazioni. In pratica, oltre una certa profondità, l'addestramento diventa sempre più difficile e i benefici iniziano a ridursi.
Nel 2015 la Residual Network (ResNet) introdusse una soluzione elegante a questo limite.
Le Residual Connections introducono un percorso diretto che permette a parte dell'informazione di attraversare la rete senza essere continuamente trasformata, riducendo il rischio di degradazione nelle architetture profonde. Mi piace immaginare queste connessioni come delle autostrade.
Le innovazioni più importanti raramente sostituiscono completamente ciò che esisteva prima. Molto più spesso recuperano idee già consolidate e le riutilizzano in un contesto diverso.
Questa idea si rivelerà così efficace da diventare uno degli elementi fondamentali anche dell'architettura Transformer.
Dentro il meccanismo di attenzione
L'architettura è composta da una sequenza di layer praticamente identici. Ogni layer riceve in ingresso una rappresentazione del testo e la restituisce leggermente migliore rispetto a prima.
Query, Key e Value
Immaginiamo la seguente frase:"Il satellite osserva la Terra mentre attraversa l'orbita."
Quando il modello elabora il token orbita, non tutte le parole hanno la stessa importanza. È ragionevole aspettarsi che attribuisca maggiore attenzione a termini come satellite e Terra, mentre articoli e congiunzioni contribuiranno molto meno alla comprensione del significato.
Ogni token viene trasformato contemporaneamente in tre rappresentazioni differenti:
- Query, che rappresenta ciò che il token sta cercando.
- Key, che descrive quali informazioni ogni altro token può offrire.
- Value, che contiene il contenuto informativo vero e proprio.
Query, Key e Value non sono entità differenti memorizzate nel modello, ma proiezioni lineari della stessa rappresentazione del token ottenute attraverso matrici di peso apprese durante l'addestramento.
L'Attention è una somma pesata
Una volta calcolato quanto ogni token sia rilevante rispetto agli altri, il modello deve combinare queste informazioni e lo si fa attraverso una somma pesata.
I token ritenuti più importanti contribuiscono maggiormente alla rappresentazione finale, mentre quelli meno rilevanti hanno un impatto ridotto. La rappresentazione di ciascun token non dipende quindi soltanto dal suo significato originale, ma diventa il risultato del contesto in cui compare.
Questo è il motivo per cui una stessa parola può assumere rappresentazioni differenti a seconda della frase in cui viene utilizzata.
Il significato non è più una proprietà della parola stessa ma del contesto.
Multi-Head Attention
Una conversazione può essere osservata da punti di vista differenti, quindi una sequenza può contenere diversi tipi di relazioni contemporaneamente. Una singola operazione di attenzione rischierebbe di cogliere soltanto una parte di queste relazioni.
Per questo il Transformer utilizza la Multi-Head Attention.
Invece di costruire un'unica rappresentazione del contesto, il modello esegue contemporaneamente più meccanismi di attenzione indipendenti. Ogni head può specializzarsi nell'apprendere relazioni differenti. Al termine dell'elaborazione tutte le differenti prospettive vengono riunite in un'unica rappresentazione più ricca del contesto.
È un po' come osservare un problema attraverso gli occhi di più specialisti prima di prendere una decisione.
KV Cache
Durante la generazione autoregressiva il modello produce un token alla volta. Sarebbe estremamente inefficiente ricalcolare a ogni passo tutte le rappresentazioni dei token già elaborati.

Per questo vengono memorizzati i vettori Key e Value prodotti dalla Self-Attention. Questa struttura prende il nome di KV Cache. Ciò che è già stato elaborato viene riutilizzato.
Il modello deve quindi calcolare soltanto il nuovo token e confrontarlo con le informazioni già presenti nella cache.
La KV Cache rappresenta una delle ottimizzazioni più importanti degli LLM moderni ma introduce un altro collo di bottiglia. Più aumenta il contesto, più cresce la memoria necessaria per memorizzare la cache, fino a occupare decine di gigabyte nei modelli più grandi.
Non tutte le cache sono uguali
Quando si parla di "caching" negli LLM si sovrappongono spesso due concetti molto diversi che operano a livelli differenti. Confonderli porta a valutazioni errate su latenza, memoria GPU e costi delle API.
A ogni nuovo token generato, la Self-Attention necessita dei vettori Key e Value di tutti i token precedenti della sequenza. Senza caching, queste matrici andrebbero ricalcolate da capo a ogni singolo passo, un'operazione molto impattante per la latenza e la VRAM.
La KV Cache memorizza i vettori Key/Value già calcolati e li riutilizza durante la generazione.
- Il vantaggio: Rende ogni singolo passo di generazione più veloce ed economico.
- Il collo di bottiglia: Vive nella memoria della GPU. Più la finestra di contesto cresce, più la KV Cache divora VRAM. È proprio per risolvere questo problema che sono nate ottimizzazioni come PagedAttention o la Multi-Head Latent Attention (MLA).
La LLM Cache risiede al livello dell'applicazione e il suo scopo è evitare del tutto di chiamare il modello.
- Exact-match cache: Memorizza direttamente le coppie
prompt → risposta. Se la richiesta è identica, restituisce il risultato salvato.
- Semantic cache: Utilizza gli embedding per individuare domande formulate in modo diverso ma con lo stesso significato semantico, fornendo la risposta in cache senza consumare un solo token di inferenza.
Oggi la linea di demarcazione tra queste due tecnologie sta diventando sempre più sottile.
Le API di "Prompt Caching" offerte dai principali provider (come OpenAI o Anthropic) rappresentano concettualmente la KV Cache che "sfonda" il livello del modello per arrivare al livello applicativo: consentono infatti di riutilizzare lo stato dell'attenzione tra richieste differenti e non solo all'interno della medesima sessione di generazione.
FlashAttention
Quando si parla di FlashAttention si tende spesso a descriverlo come un algoritmo "più veloce", in realtà il suo contributo è molto più interessante.
Cambia il modo in cui i dati attraversano la gerarchia di memoria della GPU. Invece di materializzare grandi matrici intermedie nella memoria HBM, FlashAttention suddivide il calcolo in blocchi (tiling), sfruttando molto più efficacemente la memoria SRAM, decisamente più veloce ma anche molto più limitata. In altre parole, FlashAttention rappresenta uno dei primi esempi in cui l'evoluzione degli LLM nasce non da una nuova idea di machine learning, ma da una profonda comprensione dell'architettura hardware.
Negli LLM moderni il collo di bottiglia non è sempre il numero di operazioni matematiche. Molto spesso è la quantità di dati che devono essere continuamente trasferiti tra memoria e unità di calcolo.
Multi-Head Latent Attention
Proprio la crescita della KV Cache ha spinto la ricerca verso nuove varianti dell'attenzione capaci di utilizzare la memoria in modo più efficiente. Con l'aumento della lunghezza del contesto è emerso infatti un nuovo problema.
Durante l'inferenza la KV Cache cresce continuamente, fino a occupare una quantità enorme di memoria. Una soluzione consiste nel cambiare il modo in cui vengono memorizzate le informazioni.
La Multi-Head Latent Attention (MLA) proietta infatti le rappresentazioni di Key e Value in uno spazio latente molto più compatto prima di salvarle nella cache. Durante l'inferenza il modello lavora quindi su rappresentazioni compresse, riducendo in modo significativo il consumo di memoria senza rinunciare ai vantaggi della Self-Attention.
DeepSeek ha contribuito in modo significativo alla diffusione industriale della Multi-Head Latent Attention. Rappresenta bene la direzione intrapresa dalle architetture più recenti: non sostituire la Self-Attention, ma renderla progressivamente più efficiente.
Feed Forward Network
Dopo la fase di attenzione entra in gioco il Feed Forward Network (FFN).
Se la Self-Attention stabilisce quali informazioni sono importanti, il Feed Forward Network elabora invece ciascun token individualmente, arricchendone la rappresentazione sulla base del contesto appena costruito.
Ogni token attraversa una piccola rete neurale completamente connessa, identica per tutti i token, che elabora ciascuna rappresentazione separatamente:
- La Self-Attention costruisce le relazioni, mette in relazione i token;
- La Feed Forward Network le elabora, trasforma la rappresentazione.
Questa alternanza tra attenzione condivisa ed elaborazione locale rappresenta uno degli elementi fondamentali dell'architettura del Transformer. Ripetendo questo schema decine di volte, il modello costruisce progressivamente una comprensione sempre più sofisticata del testo.
Residual Connections e Layer Normalization
Con l'aumento della profondità dei modelli diventa fondamentale preservare la stabilità dell'addestramento. Ogni layer modifica progressivamente la rappresentazione del testo ma c'è un rischio: se ogni trasformazione sostituisse completamente quella precedente, alcune informazioni potrebbero degradarsi o andare perse.
Per evitare questo problema il Transformer eredita una delle idee più importanti introdotte dalle ResNet: le Residual Connections. Le connessioni residue permettono di propagare l'informazione attraverso molti layer senza degradarla.
Ogni layer non lavora mai su una rappresentazione completamente nuova, l'output del layer viene sommato all'input del layer stesso. Così facendo il modello può introdurre nuove informazioni senza perdere quelle già apprese nei livelli precedenti.
Subito dopo interviene la Layer Normalization, che mantiene stabile la distribuzione numerica delle attivazioni, rendendo l'addestramento più robusto e facilitando la convergenza di reti molto profonde.
Arrivare alla previsione del token successivo
Dopo aver attraversato decine di layer, il modello possiede una rappresentazione estremamente ricca del contesto. Per decidere quale token generare il modello calcola un valore numerico chiamato logit per ogni possibile token del vocabolario. Un logit non rappresenta ancora una probabilità, si può interpretare come un punteggio che misura quanto il modello ritenga plausibile ciascuna possibile continuazione della sequenza.
Per trasformare questi punteggi in probabilità interviene la funzione Softmax che normalizza tutti i logits in modo che la loro somma sia pari a uno, producendo una vera distribuzione di probabilità.
Il token con probabilità più elevata non viene necessariamente scelto in modo deterministico.
Durante l'inferenza possono essere applicate tecniche come temperatura, top-k o top-p sampling, che introducono un grado controllato di variabilità nella generazione.
Una stessa architettura, tre modi diversi di utilizzarla
Encoder-only
L'obiettivo non è generare nuovo testo, ma costruire la migliore rappresentazione possibile di quello esistente. Il modello dispone quindi dell'intero contesto e può comprenderne il significato nel modo più completo possibile.
Questa caratteristica rende gli Encoder particolarmente efficaci per attività come:
- classificazione del testo;
- analisi del sentiment;
- Named Entity Recognition (NER);
- ricerca semantica;
- embedding;
- recupero documentale.
Il rappresentante più famoso di questa famiglia è BERT.
Più che generare testo, BERT ha cambiato il modo in cui i modelli comprendono il linguaggio.
Decoder-only
Qui viene utilizzato soltanto il Decoder. Durante la generazione ogni token può osservare esclusivamente il passato e non conosce ancora le parole che verranno dopo.
Questo vincolo, chiamato causal masking, impedisce al modello di "sbirciare nel futuro" e lo obbliga a prevedere il token successivo utilizzando soltanto il contesto disponibile fino a quel momento.
È esattamente questo meccanismo che rende possibile una conversazione con un LLM.
Il modello genera una parola alla volta, aggiornando continuamente il contesto con ogni nuovo token prodotto.
Da questa famiglia derivano gran parte dei modelli generativi moderni:
- GPT;
- Llama;
- Mistral;
- Qwen;
- DeepSeek;
- Gemma;
- Phi;
- e molti altri..
Anche se differiscono per dimensioni, tecniche di addestramento e ottimizzazioni interne, condividono tutti la stessa filosofia architetturale: prevedere il token successivo.
Encoder-Decoder
L'Encoder analizza il testo in ingresso costruendone una rappresentazione contestuale.
Il Decoder utilizza questa rappresentazione per produrre una nuova sequenza.
Questa architettura è particolarmente adatta ai problemi in cui l'obiettivo non è semplicemente continuare un testo, ma trasformarlo:
- traduzione automatica;
- riassunto di documenti;
- correzione grammaticale;
- risposta a domande;
- trasformazioni testo-testo.
Tra queste tre famiglie, sono soprattutto le architetture decoder-only ad aver dato origine ai moderni Large Language Model. A questo punto possiamo quindi osservare come un Transformer decoder-only, aumentando di scala, diventi un vero LLM.
Confrontare rappresentazioni
Un modello può trasformare informazioni diverse in rappresentazioni vettoriali, ma queste rappresentazioni possono anche essere confrontate tra loro.
Consideriamo per esempio due encoder, uno per le immagini e uno per il testo:
- (f(x)) trasforma un'immagine in un vettore;
- (g(t)) trasforma una descrizione testuale in un vettore.
Il sistema calcola quindi la similarità tra le rappresentazioni, spesso utilizzando la similarità coseno.
Un valore elevato indica che le due rappresentazioni sono fortemente allineate nello spazio vettoriale, mentre un valore più basso indica una minore compatibilità.
Durante l'addestramento, il modello può essere guidato a rendere più simili le rappresentazioni che corrispondono tra loro e meno simili quelle che non corrispondono.
Il principio sembra semplice, ma introduce una possibilità importante: un modello può essere addestrato non soltanto a prevedere quale informazione generare, ma anche a riconoscere quali rappresentazioni siano compatibili tra loro. Ripetendo questo processo su grandi quantità di dati, il modello impara a organizzare lo spazio delle rappresentazioni in modo che elementi associati risultino più facilmente riconoscibili.
Questo concetto diventa particolarmente interessante quando si dai modelli generativi ai sistemi progettati per prendere decisioni.
Dal Transformer ai Large Language Model
A questo punto tutti gli elementi fondamentali sono presenti: embedding, positional encoding, self-attention, feed forward network, residual connection, layer normalization.
Ripetendo questi blocchi centinaia di volte e addestrandoli su quantità enormi di dati, nasce la famiglia dei Large Language Model.
L'architettura di base rimane sorprendentemente stabile, ciò che cambia è la scala: più layer, più parametri, più dati, più potenza di calcolo.
Però aumentando il numero di parametri e la lunghezza del contesto iniziano a emergere nuovi limiti.
A questo punto il problema non è più soltanto il modello, ma l'infrastruttura necessaria per eseguirlo. La memoria delle GPU diventa insufficiente. Il traffico verso la memoria HBM cresce rapidamente. L'inferenza diventa sempre più costosa.
Ed è proprio da questi nuovi colli di bottiglia che prenderà forma la successiva evoluzione delle architetture.
Le scaling laws
La strategia di aumentare la scala, spesso riassunta con il termine scaling laws, ha prodotto risultati straordinari. Modelli sempre più grandi hanno dimostrato capacità che sembravano irraggiungibili solo pochi anni prima.
All'aumentare di tre fattori fondamentali:
- numero di parametri;
- quantità di dati;
- potenza di calcolo impiegata per l'addestramento;
le prestazioni dei modelli miglioravano seguendo un andamento sorprendentemente regolare.
Modelli come GPT-3 hanno rappresentato la dimostrazione pratica di questa filosofia.
In-Context learning
Tra i risultati più sorprendenti di questa fase c'è un concetto che oggi diamo quasi per scontato: l'In-Context Learning. Prima di GPT-3, la procedura tipica era relativamente semplice. Se si voleva che un modello imparasse un nuovo compito, era necessario raccogliere un dataset specifico ed eseguire una nuova fase di addestramento o di fine-tuning. Questa capacità deriva dalla rappresentazione appresa durante l'addestramento e dalla capacità del Transformer di utilizzare il contesto come memoria temporanea. GPT-3 è stato il primo modello a mostrarne chiaramente l'efficacia su larga scala. In molti casi era sufficiente descrivere il problema direttamente all'interno del prompt oppure fornire uno o due esempi. Il modello riusciva a comprendere il compito e a generalizzarlo senza alcuna modifica dei propri pesi.
Il contesto diventa, a tutti gli effetti, una forma temporanea di memoria operativa.
Capacità emergenti
Al crescere della scala iniziarono infatti a comparire capacità che sembravano non essere presenti nei modelli più piccoli. Questi fenomeni sono spesso descritti come Emergent Capabilities, anche se la loro interpretazione è ancora oggetto di dibattito nella comunità scientifica.
Il termine "emergente" indica semplicemente che alcune abilità diventano osservabili solo oltre una determinata scala.
System 1 e System 2
Fino a questo punto abbiamo seguito l'evoluzione dei modelli che elaborano e generano linguaggio.
Ma non tutti i problemi richiedono di produrre una sequenza di testo.
In molte applicazioni un modello deve semplicemente prendere una decisione: classificare una richiesta, scegliere uno strumento, stabilire quale documento sia più rilevante oppure decidere quale azione sia più appropriata. Generare una risposta completa per risolvere questi problemi può essere molto più complesso di quanto sia realmente necessario.
Per comprendere questa differenza è utile richiamare la distinzione tra System 1 e System 2, resa popolare dalla psicologia cognitiva di Daniel Kahneman.
- Il System 1 rappresenta un'elaborazione rapida, istintiva e automatica. Come fa notare il pioniere dell'AI Yoshua Bengio, è l'equivalente di guidare verso casa su un percorso familiare: lo fai in automatico, senza pensarci, magari chiacchierando. Altri esempi potrebbero essere riconoscere un oggetto, classificare una situazione, scegliere tra alcune alternative.
- Il System 2, al contrario, è un'elaborazione lenta, deliberata e cosciente. È come guidare in una città che non conosci: devi smettere di parlare, fare attenzione ai cartelli e pianificare le svolte con logica.
Questa distinzione non identifica due architetture neurali ,è soprattutto un modello concettuale utile per descrivere due modi differenti di affrontare un problema.
Come fa notare Andrej Karpathy, gli attuali LLM generativi operano quasi esclusivamente in modalità System 1: sono progettati per "sputare fuori" parole (sequenze di token) in sequenza, muovendosi su un binario predeterminato a velocità costante. Non hanno la capacità nativa di fermarsi, esplorare diverse angolazioni e ragionare prima di rispondere.
Questo ci porta a un paradosso: la generazione di token rende questi modelli estremamente flessibili, ma significa anche che un compito decisionale (che per noi è una scelta netta) viene risolto attraverso un processo di predizione testuale molto più complesso del necessario, che a volte porta a "allucinazioni" o errori logici.
La domanda diventa quindi:
È possibile costruire un modello progettato direttamente per prendere decisioni, invece di generare testo?
Per rispondere dobbiamo tornare alle rappresentazioni vettoriali che introdotte precedentemente.
Constrastive Learning
Un modello può trasformare un'informazione in una rappresentazione vettoriale e che possiamo confrontare due rappresentazioni attraverso una misura di similarità.
Il Contrastive Learning utilizza proprio questa idea durante l'addestramento. Invece di insegnare al modello soltanto a prevedere quale token venga dopo, possiamo insegnargli a distinguere le rappresentazioni che devono essere associate da quelle che non devono esserlo.
Immaginiamo, per esempio, di avere uno stato del sistema e alcune possibili azioni. Durante l'addestramento vogliamo che la rappresentazione dello stato sia più compatibile con l'azione corretta e meno compatibile con le alternative.
Possiamo quindi costruire due tipi di esempi:
- una coppia positiva, nella quale stato e azione sono coerenti;
- una coppia negativa, nella quale lo stato viene associato a un'azione non corretta o meno appropriata.
Il modello cerca di aumentare la similarità delle coppie positive e ridurre quella delle coppie negative.
La similarità coseno, quindi, può essere utilizzata per misurare l'allineamento tra due rappresentazioni, mentre la funzione obiettivo contrastiva guida il modello nell'apprendimento di quali allineamenti siano utili.
La similarità misura una relazione; il Contrastive Learning insegna al modello quali relazioni deve imparare a riconoscere.
Il Contrastive Learning non è un'architettura e non appartiene esclusivamente ai modelli System 1.
È un metodo di apprendimento che può essere utilizzato in contesti molto diversi, dall'allineamento tra immagini e testo fino alla selezione di azioni o alla ricerca semantica.
Contrastive Language Model
Il passo successivo consiste nel trasformare il confronto tra rappresentazioni nel meccanismo principale con cui il modello prende una decisione. È questa l'idea alla base dei Contrastive Language Models (CLM).
Un CLM può ricevere uno stato, cioè la situazione corrente, e una serie di azioni candidate.
Lo stato viene trasformato in una rappresentazione vettoriale e ogni azione viene trasformata in una propria rappresentazione.
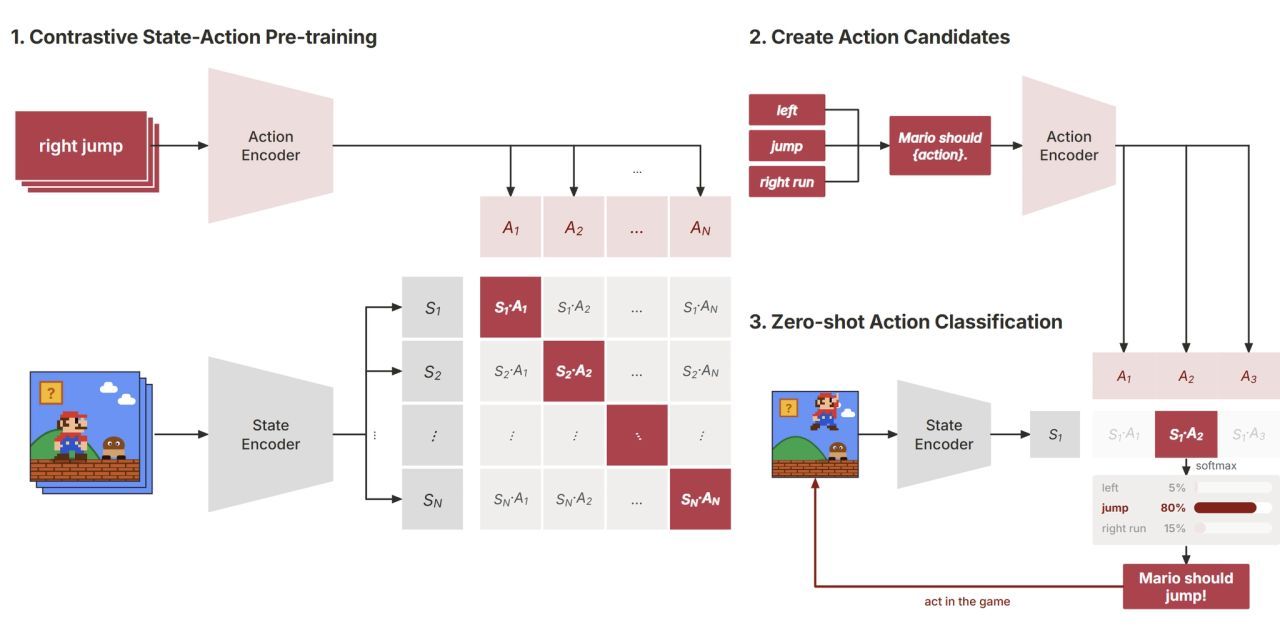
Il modello può quindi calcolare quanto ciascuna azione sia compatibile con lo stato.
stato → rappresentazione
azione A → rappresentazione
azione B → rappresentazione
azione C → rappresentazione
Il sistema confronta quindi le rappresentazioni e assegna un punteggio alle diverse alternative. L'azione che risulta maggiormente compatibile con lo stato può essere selezionata direttamente, senza dover generare una sequenza di testo.
Un LLM generativo cerca di rispondere alla domanda:"Qual'è il prossimo token che devo generare?"
Un modello contrastivo orientato alla decisione può invece rispondere alla domanda:"Quale delle alternative disponibili è più compatibile con la situazione attuale?"
CLM-8B, pubblicato a settembre 2026, è un esempio di questo approccio. Il modello utilizza un encoder Qwen3-8B con due projection head, una per lo stato e una per l'azione, e un obiettivo basato su InfoNCE. Il modello non deve necessariamente spiegare la decisione attraverso il linguaggio ma soltanto produrre un risultato che il software possa utilizzare.
Rientra nei modelli System One, ma usa due reti distinte: un encoder di stato e un encoder di azione, i cui output vettoriali vengono confrontati tramite un’operazione di similarità (coseno).
Durante l’addestramento, la coppia corretta (stato, azione vera) viene avvicinata nello spazio latente, mentre le coppie errate vengono spinte via, usando la loss InfoNCE (un softmax contrastivo).
A differenza di Jev, CLM non può generare nuove risposte: funziona solo con l’insieme di azioni candidate fornite dall’applicazione. Questo approccio dual-encoder consente di cachare le embeddings delle azioni riutilizzate e calcolare solo l’embedding dello stato ogni volta, riducendo drasticamente il costo computazionale per confronti ripetuti.
Jev
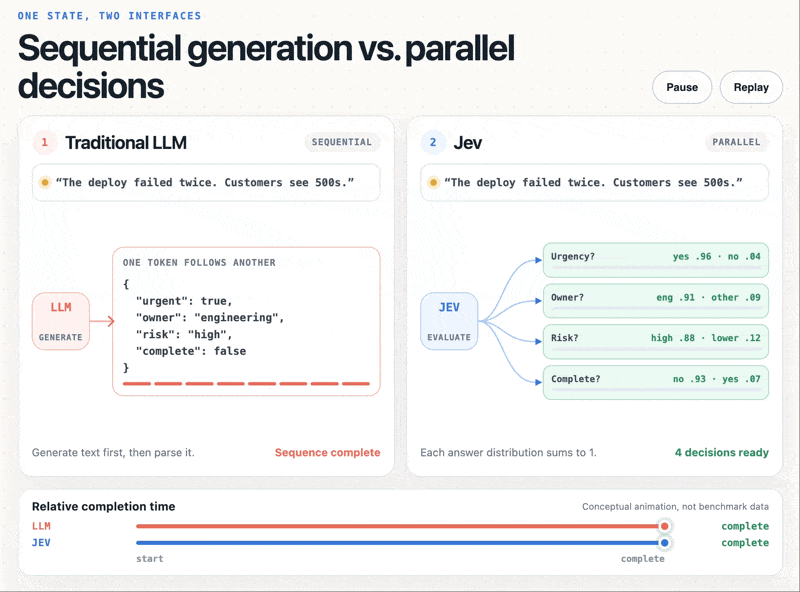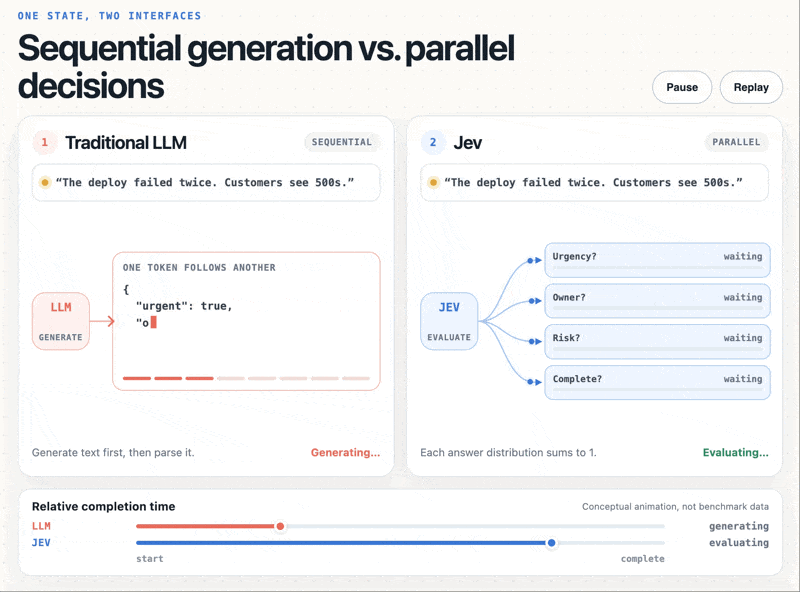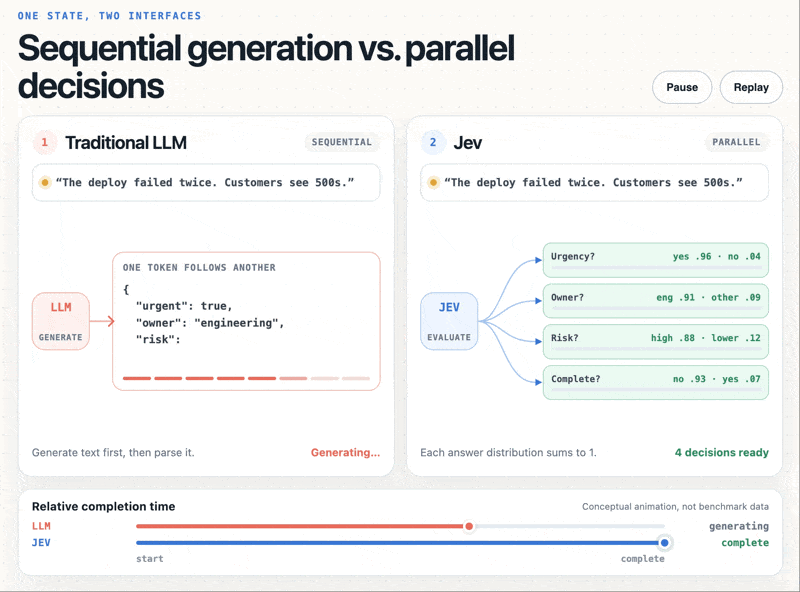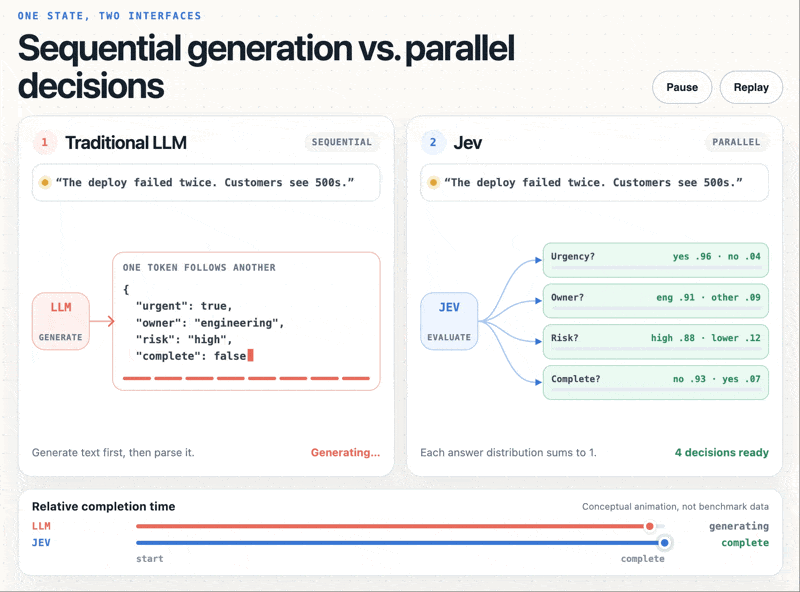
CLM non è l'unico esempio di questa nuova direzione. Sempre nel settembre 2026 TypeSafe AI ha presentato Jev: un modello progettato per produrre decisioni strutturate (classificazione, routing, scoring, etc..).
L'idea di base è molto semplice:
State → Question → Decision → Action
Il sistema riceve lo stato corrente, le informazioni disponibili in quel momento, e una domanda focalizzata. La risposta non è necessariamente un testo libero, può essere una scelta tra diverse alternative, un punteggio oppure una valutazione sì/no associata a una probabilità.
- Lo stato è semplicemente il materiale su cui si ragiona: il testo di una email, una scheda cliente, il verbale di una riunione.
- Le domande, che si scrivono in anticipo e hanno risposte già stabilite.
Per esempio possiamo formulare all'LLM una domanda molto più precisa e mirata:"Quale team deve gestire questa richiesta?" e definire le alternative possibili.
Le domande si fanno tutte in una volta e il modello le valuta in parallelo, ciascuna in modo indipendente dalle altre.
User Query
    ↓
FastAPI
    ↓
Jev — Decision Layer
    ↓
 ┌──────────┬──────────┬──────────┐
 │   RAG    │  Tools   │   LLM    │
 └──────────┴──────────┴──────────┘
    ↓
Structured Response
Il modello può quindi restituire direttamente la decisione e le relative probabilità, lasciando al software il compito di stabilire cosa fare successivamente.
Le risposte possibili sono di tre tipi soltanto:
- Il primo tipo è la scelta fra opzioni che decidete voi: materia, ufficio competente, tipo di pratica. Per ognuna si scrive il criterio, cioè la riga che spiega quando si applica. Il modello restituisce l'opzione scelta e la probabilità attribuita a ciascuna delle altre.
- Il secondo è il voto su una scala: da due a dieci livelli ordinati, descritti a parole («cliente tranquillo che espone fatti», «cliente contrariato ma civile», «cliente molto arrabbiato»). Torna indietro un punteggio, che può cadere anche a metà strada fra due livelli.
- Il terzo è la domanda vero o falso, che non torna come un sì o un no ma come una probabilità fra 0 e 1. Alla frase «il messaggio esprime urgenza» il modello può rispondere 0,999.
Sullo stesso messaggio si possono mettere insieme, in una sola richiesta: materia (scelta fra le voci dello studio), urgenza (vero o falso, con probabilità), tono del cliente (voto su tre livelli), c'è una scadenza nominata nel testo (vero o falso), il mittente è già cliente (vero o falso).
La risposta arriva in un tempo che sta fra i 70 e i 500 millisecondi, e costa 4 centesimi di dollaro ogni milione di parole che gli date da leggere.
TypeSafe dichiara per il modello un diverso metodo di addestramento, chiamato Reinforcement Learning for Calibrated Decisions (RLCD), in pratica, un RL che incentiva l’accuratezza probabilistica delle risposte verificabili.
La matematica sottostante non è pubblicata in dettaglio, ma si basa su un Transformer che produce direttamente le probabilità delle risposte. Rinunciare alla generazione testuale semplifica l’ottimizzazione: la funzione di perdita può essere una normale cross-entropy sulle etichette delle domande (o un RL con ricompense certificate).
In ogni caso, l’effetto pratico è che Jev non può “allucinare” testo, garantendo output verificabili.
Alternative simili
Altri modelli emergenti simili (open-source) completano il panorama:
- Laya/Von: modelli encoder-based (tipo BERT) con teste di decisione aperte (scelta, punteggio, sì/no). Ad esempio Von (395M) usa ModernBERT-large e valuta tutte le opzioni in un solo forward pass senza generazione. Laya (421M) simile, anche multilingue.
- Kev/Tev: modelli autoregressivi fine-tuned come Jev. Kev (0.8–27B) è un Qwen3-base fine-tuned compatibile con l’API Jev. Tev1-4B (Together AI, 2026) è Qwen3.5-4B fine-tuned che risponde con la lettera dell’opzione corretta.
- Soluzioni ibride o training-free: per esempio SemIf e AnyJev usano LLM preesistenti e applicano calibrazioni, senza training specifico.
Di seguito una tabella riassuntiva delle architetture principali:
| Modello / Categoria | Architettura (Base) | Addestramento | Output / Funzionamento |
|---|---|---|---|
| Jev (TypeSafe) | Transformer autoregressivo con parallel sampling | RLCD (reinforcement learning) | Risposte strutturate parallele, con probabilità calibrate |
| CLM (Stanford/Nvidia) | Doppio encoder (stato + azioni) su backbone Qwen-8B | Supervised contrastive (loss InfoNCE) | Selezione dell’azione migliore (più simile) con probabilità |
| Laya / Von | Encoder bidirezionale (ModernBERT, mmBERT) con teste finali | Supervised fine-tuning su domande etichettate | Probabilità per ogni opzione in un colpo solo (no generazione) |
| Kev / Tev | Decoder LLM (Qwen, Raven, Llama, etc.) fine-tuned | Supervised fine-tuning con domande e risposte | Risposta generata per ogni domanda (spesso come lettera di opzione) |
| SemIf / AnyJev | Nessuna rete nuova; usa LLM congelato e logit esistenti | Nessun training (calibrazione e rimpiazzo diretto) | Classifica i risultati dell’LLM in base alla probabilità calibrata |
Rischi, limitazioni e domande aperte
Le architetture contrastive come CLM presentano vantaggi e vincoli.
- Vantaggi: riducono drasticamente la latenza in scenari con scelte ripetute e spesso garantiscono output con probabilità più affidabili (calibrate) rispetto agli LLM generativi.
- Limiti: CLM dipende dalle azioni candidate fornite; se queste non contengono la risposta giusta, il modello non può correggersi. Inoltre, non è adatto a compiti creativi o aperti. Jev invece non può generare opzioni non previste nel suo schema di domande e richiede feedback calibrato tramite addestramento RL sofisticato.
- Altri aspetti aperti: scalabilità (che succede aumentando modelli e dati?), supervisione umana (come raccogliere dati di addestramento di alta qualità per dominio?), e sicurezza (anche se CLM segnala incertezza, non è una garanzia di fallback corretto). Rimane da investigare il bilanciamento ottimale nel routing multi-modello (quando usare un LLM generativo vs un modello come CLM) e come integrare queste decisioni in pipeline di produzione robuste.
L'era dell'efficienza
L'addestramento richiedeva settimane o mesi. Il consumo energetico cresceva rapidamente.
Anche l'inferenza, cioè la fase in cui utilizziamo quotidianamente un LLM, iniziava a diventare sempre più costosa.
Crescere all'infinito non è sostenibile e l'obiettivo adesso non è più soltanto costruire modelli più intelligenti, ma renderli più efficienti.
Gli Small Language Model (SLM)
Un'altra filosofia ha iniziato a guadagnare sempre più attenzione: costruire modelli più piccoli, meno costosi e più facili da distribuire, mantenendo prestazioni sorprendentemente elevate.
L'obiettivo non è competere con i modelli di frontiera su qualsiasi attività, ma ottenere il miglior compromesso tra qualità, costo e latenza. Per raggiungere questo risultato vengono utilizzate diverse tecniche:
- La Knowledge Distillation trasferisce le conoscenze di un grande modello ("teacher") a uno più piccolo ("student"), che impara a riprodurne il comportamento.
- La Pruning elimina connessioni e parametri poco significativi.
- La Quantizzazione riduce la precisione numerica dei pesi, diminuendo drasticamente memoria occupata e consumo di banda durante l'inferenza.
Non sempre innovare significa costruire modelli più grandi, a volte significa costruire modelli sufficientemente intelligenti da poter essere eseguiti ovunque.
Quando il problema non sono più i token, ma i parametri
Ogni token attraversa l'intera rete neurale, anche quando soltanto una piccola parte dei parametri sarebbe realmente necessaria.
Un modello da centinaia di miliardi di parametri utilizza tutta la propria capacità per elaborare ogni singolo token, una strategia potente ma estremamente costosa.
Mixture of Experts: specializzare invece di attivare tutto
Immaginiamo un grande gruppo di specialisti, non avrebbe senso convocarli tutti per qualsiasi domanda. È molto più efficiente scegliere soltanto quelli realmente competenti.
Lo stesso principio viene applicato alla rete neurale.
Ogni blocco contiene più esperti, un router decide dinamicamente quali esperti attivare per ogni token. Di conseguenza solo una piccola parte del modello viene realmente utilizzata durante l'inferenza. È possibile così aumentare enormemente il numero complessivo di parametri senza aumentare in modo proporzionale il costo computazionale per token.
Un modello MoE non rende automaticamente l'inferenza più economica. Riduce i FLOPs per token, ma introduce nuove complessità legate al routing, alla distribuzione del carico e alla comunicazione tra GPU.
Questo approccio è adottato in numerosi modelli di frontiera.

Tra questi, DeepSeek rappresenta una delle evoluzioni più interessanti.
Pur mantenendo l'idea generale dei Mixture of Experts, introduce un routing più granulare e una distinzione tra esperti condivisi ed esperti specializzati. Alcuni esperti rimangono sempre attivi per catturare conoscenze generali, mentre altri vengono selezionati dinamicamente in base al contenuto del token.
L'obiettivo non è soltanto ridurre il costo computazionale, ma migliorare anche la specializzazione del modello senza aumentare proporzionalmente i FLOPs per token.
Distribuire modelli sempre più grandi
I modelli più grandi semplicemente non entrano nella memoria di una singola GPU, l'unica soluzione è distribuirli:
- Il Data Parallelism distribuisce i dati
- Il Tensor Parallelism suddivide le operazioni matematiche
- Il Pipeline Parallelism ripartisce i layer del modello tra più dispositivi
Queste tecniche non modificano l'architettura del Transformer.
Ring Attention
Con finestre contestuali sempre più estese, anche distribuire il modello non è più sufficiente, diventa necessario distribuire la stessa operazione di attenzione.
Ring Attention affronta questo problema organizzando le GPU in una struttura ad anello dove ogni dispositivo elabora una parte della sequenza e scambia progressivamente le informazioni necessarie con gli altri.
In questo modo nessuna GPU deve mantenere in memoria l'intera matrice di attenzione, consentendo di estendere il contesto ben oltre i limiti della memoria di un singolo dispositivo.
Quando ottimizzare non basta
Osservando questa evoluzione emerge un aspetto interessante, ovvero che le innovazioni più recenti non cercano quasi mai di sostituire il Transformer ma di renderlo più efficiente.
- FlashAttention riduce il traffico verso la memoria.
- KV Cache evita calcoli ridondanti.
- MLA comprime le rappresentazioni.
- MoE attiva soltanto una parte della rete.
- Ring Attention distribuisce il carico su più GPU.
Sono tutte risposte diverse allo stesso problema: come continuare a scalare senza rendere insostenibili costi, memoria e tempi di esecuzione.
Negli ultimi anni, però, una parte della ricerca ha iniziato a porsi una domanda diversa: e se il limite non fosse più l'implementazione del Transformer, ma il meccanismo di Self-Attention stesso?
Per quanto ottimizzata, l'Attention continua infatti a crescere quadraticamente rispetto alla lunghezza della sequenza e richiede di mantenere in memoria una grande quantità di informazioni durante l'inferenza.
Da qui nasce una nuova generazione di architetture.
State Space Models
L'idea è costruire una rappresentazione continua dello stato del sistema che possa essere aggiornata progressivamente senza dover confrontare esplicitamente ogni token con tutti gli altri.
In altre parole, il contesto non viene ricostruito ogni volta attraverso una matrice di attenzione, viene mantenuto e aggiornato in modo dinamico.
Questo approccio consente una complessità che cresce linearmente con la lunghezza della sequenza, rendendo gli SSM particolarmente interessanti per documenti molto estesi.
Le sue basi matematiche derivano dalla teoria dei sistemi dinamici e vengono adattate al Deep Learning per rappresentare sequenze estremamente lunghe in modo più efficiente.
Mamba: la memoria torna protagonista
Tra le architetture basate sugli State Space Models, una delle più interessanti è Mamba.
Mentre il Transformer deve confrontare continuamente i token attraverso l'Attention, Mamba mantiene uno stato interno che evolve durante l'elaborazione della sequenza.

A differenza delle vecchie RNN, però, questo aggiornamento è selettivo.
Il modello impara dinamicamente quali informazioni conservare e quali dimenticare. Questa caratteristica permette di elaborare sequenze molto lunghe con costi computazionali significativamente inferiori.
Con Mamba-2 questo principio viene ulteriormente raffinato, migliorando la stabilità numerica, l'efficienza hardware e la capacità di sfruttare il parallelismo delle GPU moderne.
È una reinterpretazione moderna del concetto di memoria, costruita con gli strumenti del Deep Learning contemporaneo.
Spiking Neural Networks
Accanto agli State Space Models, un altro filone di ricerca affronta il vincolo energetico ripartendo dalla biologia: le Spiking Neural Networks (SNN).
Le architetture tradizionali operano su segnali continui ed eseguono moltiplicazioni tra matrici ad ogni ciclo, consumando risorse anche in assenza di variazioni nei dati. Il cervello umano risponde a questa inefficienza consumando circa 20 Watt, grazie a una trasmissione dell'informazione basata su impulsi elettrici discreti (spike) generati solo quando si verifica un evento.
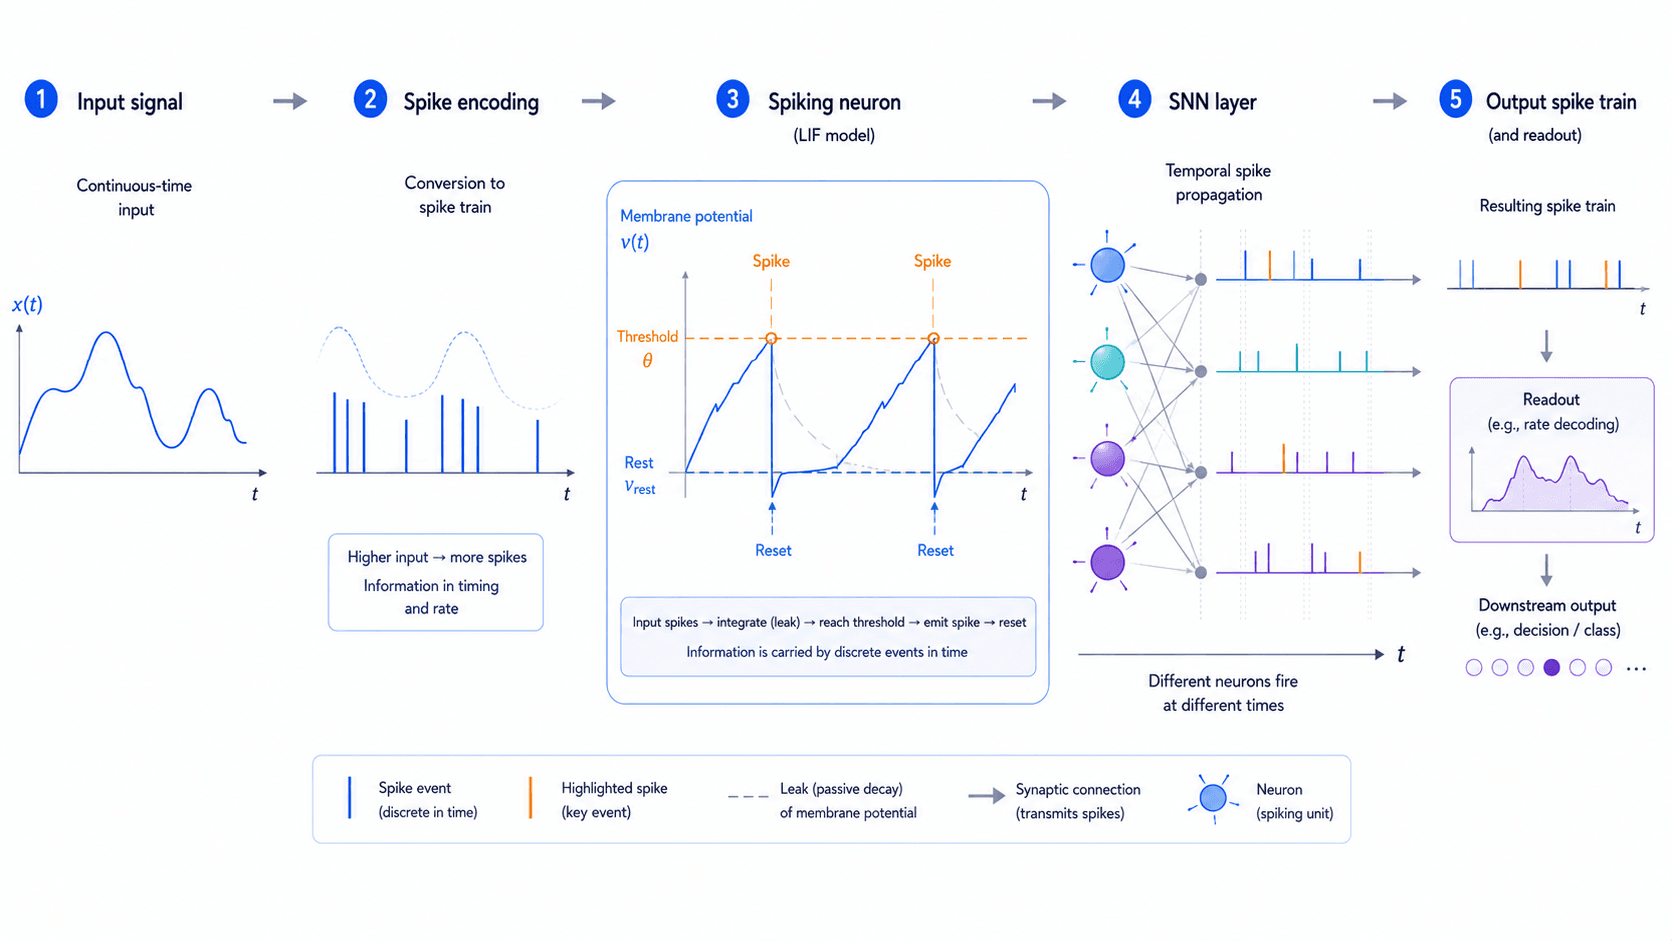
Invece di scambiarsi continuamente vettori densi di numeri decimali, una SNN comunica attraverso la frequenza o il timing preciso con cui invia questi impulsi. Il funzionamento concettuale del modello neuronale più diffuso, il Leaky Integrate-and-Fire (LIF), è molto intuitivo:
- Accumulo e perdita di carica (Integrate & Leaky): Ciascun neurone accumula l'energia degli impulsi in ingresso come un piccolo serbatoio. Se non ne arrivano di nuovi in un breve intervallo, la carica accumulata tende gradualmente a disperdersi (leaky).
- Scatto e azzeramento (Fire): Quando gli impulsi arrivano in rapida successione, la carica supera una soglia critica. A quel punto il neurone scatta, emette un singolo impulso verso i neuroni successivi e riazzera la propria carica per ricominciare il processo.
Attualmente sono studiati tre approcci principali per addestrare ed eseguire questi modelli:
- Addestramento diretto con gradienti surrogati: La natura discontinua degli impulsi impedisce l'uso diretto della backpropagation standard. Utilizzando un'approssimazione continua durante la fase di calcolo dell'errore, la rete si addestra direttamente mantenendo latenze operative ridotte a 10 millisecondi. Raggiunge un'accuratezza del 97,8% su MNIST e dell'85,7% su CIFAR-10 con soli 15 millijoules per inferenza (rispetto ai 200 millijoules delle reti convoluzionali tradizionali).
- Conversione da ANN a SNN: Consiste nel prendere una rete neurale tradizionale già addestrata e tradurre i suoi pesi continui in una frequenza di impulsi. Questo preserva quasi totalmente la precisione originaria, ma richiede molti più impulsi (circa 20.000 per inferenza) e un consumo di 20 millijoules.
- Plasticità sinaptica (STDP): Ispirata direttamente alle sinapsi biologiche, regola i collegamenti in modo locale e non supervisionato basandosi sull'ordine temporale dei singoli impulsi. Senza dover calcolare errori globali, riduce l'attività a soli 4.000 impulsi per inferenza e abbassa il consumo energetico ad appena 5 millijoules.
I vantaggi pratici del calcolo ad eventi si notano soprattutto con i sensori. Una telecamera tradizionale cattura decine di fotogrammi completi al secondo, rielaborando continuamente anche gli sfondi immobili; al contrario, una telecamera ad eventi segnala solo i singoli pixel che cambiano luminosità. Le SNN superano il 93% di accuratezza reagendo istantaneamente alle sole variazioni visive ed eliminando il calcolo superfluo sulle parti statiche della scena.
Il principale ostacolo alla diffusione su larga scala risiede nell'hardware attuale. Eseguire algoritmi asincroni sparsi su GPU progettate per il calcolo matriciale denso genera inefficienze. Il loro utilizzo su sistemi periferici, edge AI e robotica avanzata dipende dal completamento e dalla standardizzazione di chip neuromorfici dedicati.
Verso architetture ibride
La ricerca non sembra orientata verso un'unica architettura destinata a sostituire tutte le altre. Le architetture iniziano a combinarsi. Oggi stiamo iniziando a progettare sistemi che combinano idee differenti per ottenere il miglior compromesso tra capacità, efficienza e costo computazionale.
Ogni passo in avanti nasce dalla stessa domanda: qual è il limite della generazione precedente?
È probabilmente questa la lezione più importante.
Le architetture evolvono perché ogni soluzione, prima o poi, incontra un nuovo limite. È probabile che anche le architetture di domani non sostituiranno completamente quelle attuali, ma ne conserveranno le idee migliori, adattandole ai nuovi vincoli di scala, memoria ed efficienza.
Forse è questo il modo migliore per osservare l'evoluzione degli LLM.
Perché tutto questo conta davvero
Le innovazioni più importanti degli ultimi anni non derivano necessariamente da modelli radicalmente diversi, ma dalla capacità di identificare e risolvere il collo di bottiglia dominante del momento.
Ogni generazione ha dovuto affrontare un vincolo dominante: apprendimento, memoria, parallelismo, scalabilità, costo. Oggi sono costi, efficienza energetica, latenza e sostenibilità operativa.
È la stessa dinamica che osserviamo nella progettazione di piattaforme cloud, sistemi distribuiti e architetture enterprise.
Le architetture cambiano. I vincoli no.
Per questo comprendere l'evoluzione degli LLM non significa soltanto capire come funziona un modello, ma sviluppare un modo di ragionare utile per progettare sistemi AI reali.

 Davide Belotti


