IA on-premises
-
Andrea La Motta
- 23 Oct, 2026
- 03 Mins read
IA on-premises: quattro architetture enterprise a confronto, dal chiavi in mano al Kubernetes puro
Il problema non è più se portare l'intelligenza artificiale generativa in azienda, ma dove farla girare. Quando i dati sono contratti, documenti interni e informazioni dei clienti, la risposta passa sempre più spesso dal proprio data center. È una questione di sovranità dei dati, di compliance e di costi.
Il mercato offre almeno quattro strade credibili per l'IA on-premises. Le abbiamo analizzate una per una e sono più diverse di quanto sembri.
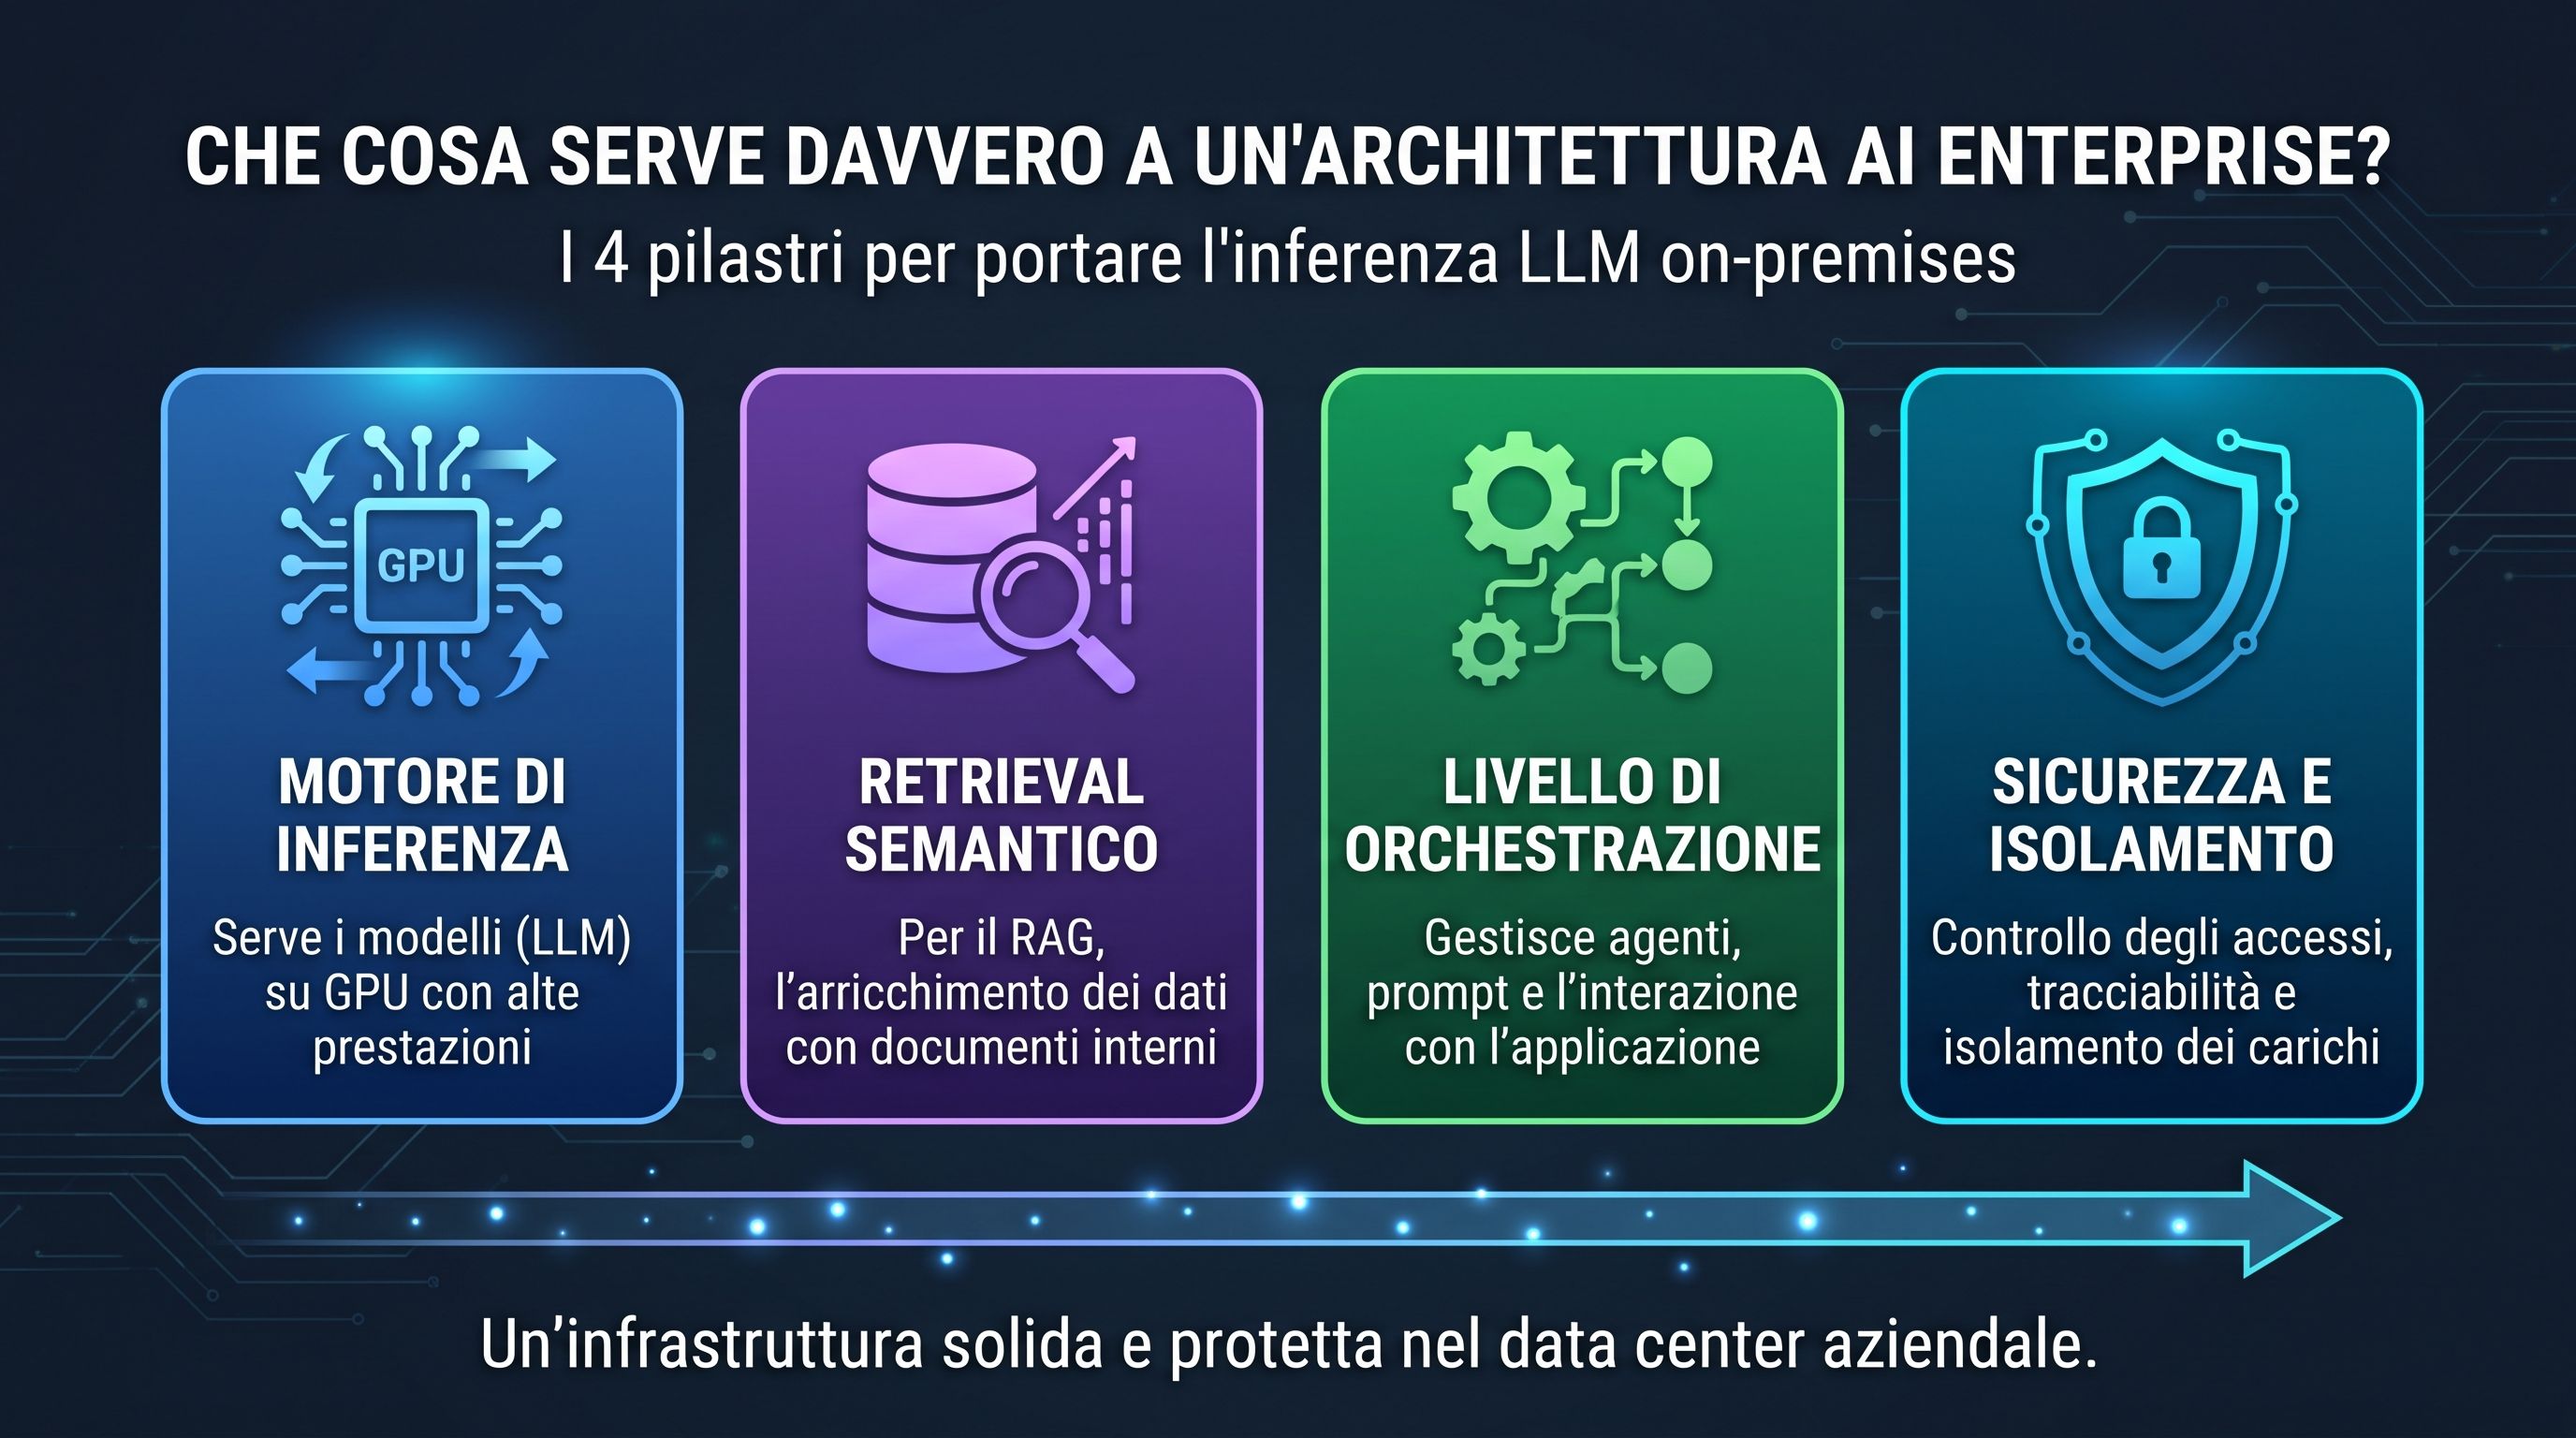
Che cosa serve davvero a un'architettura AI enterprise
Prima di confrontare i vendor conviene fissare il perimetro comune. Ogni stack che vedremo deve risolvere gli stessi problemi:
- un motore di inferenza che serva i modelli su GPU;
- un database vettoriale per il retrieval semantico (il cuore del RAG);
- un livello di orchestrazione per agenti e flussi applicativi;
- sicurezza e isolamento dei carichi, con la tracciabilità degli accessi ai dati.
Cambia il modo in cui ciascuno li assembla e quanto lavoro lascia al cliente.
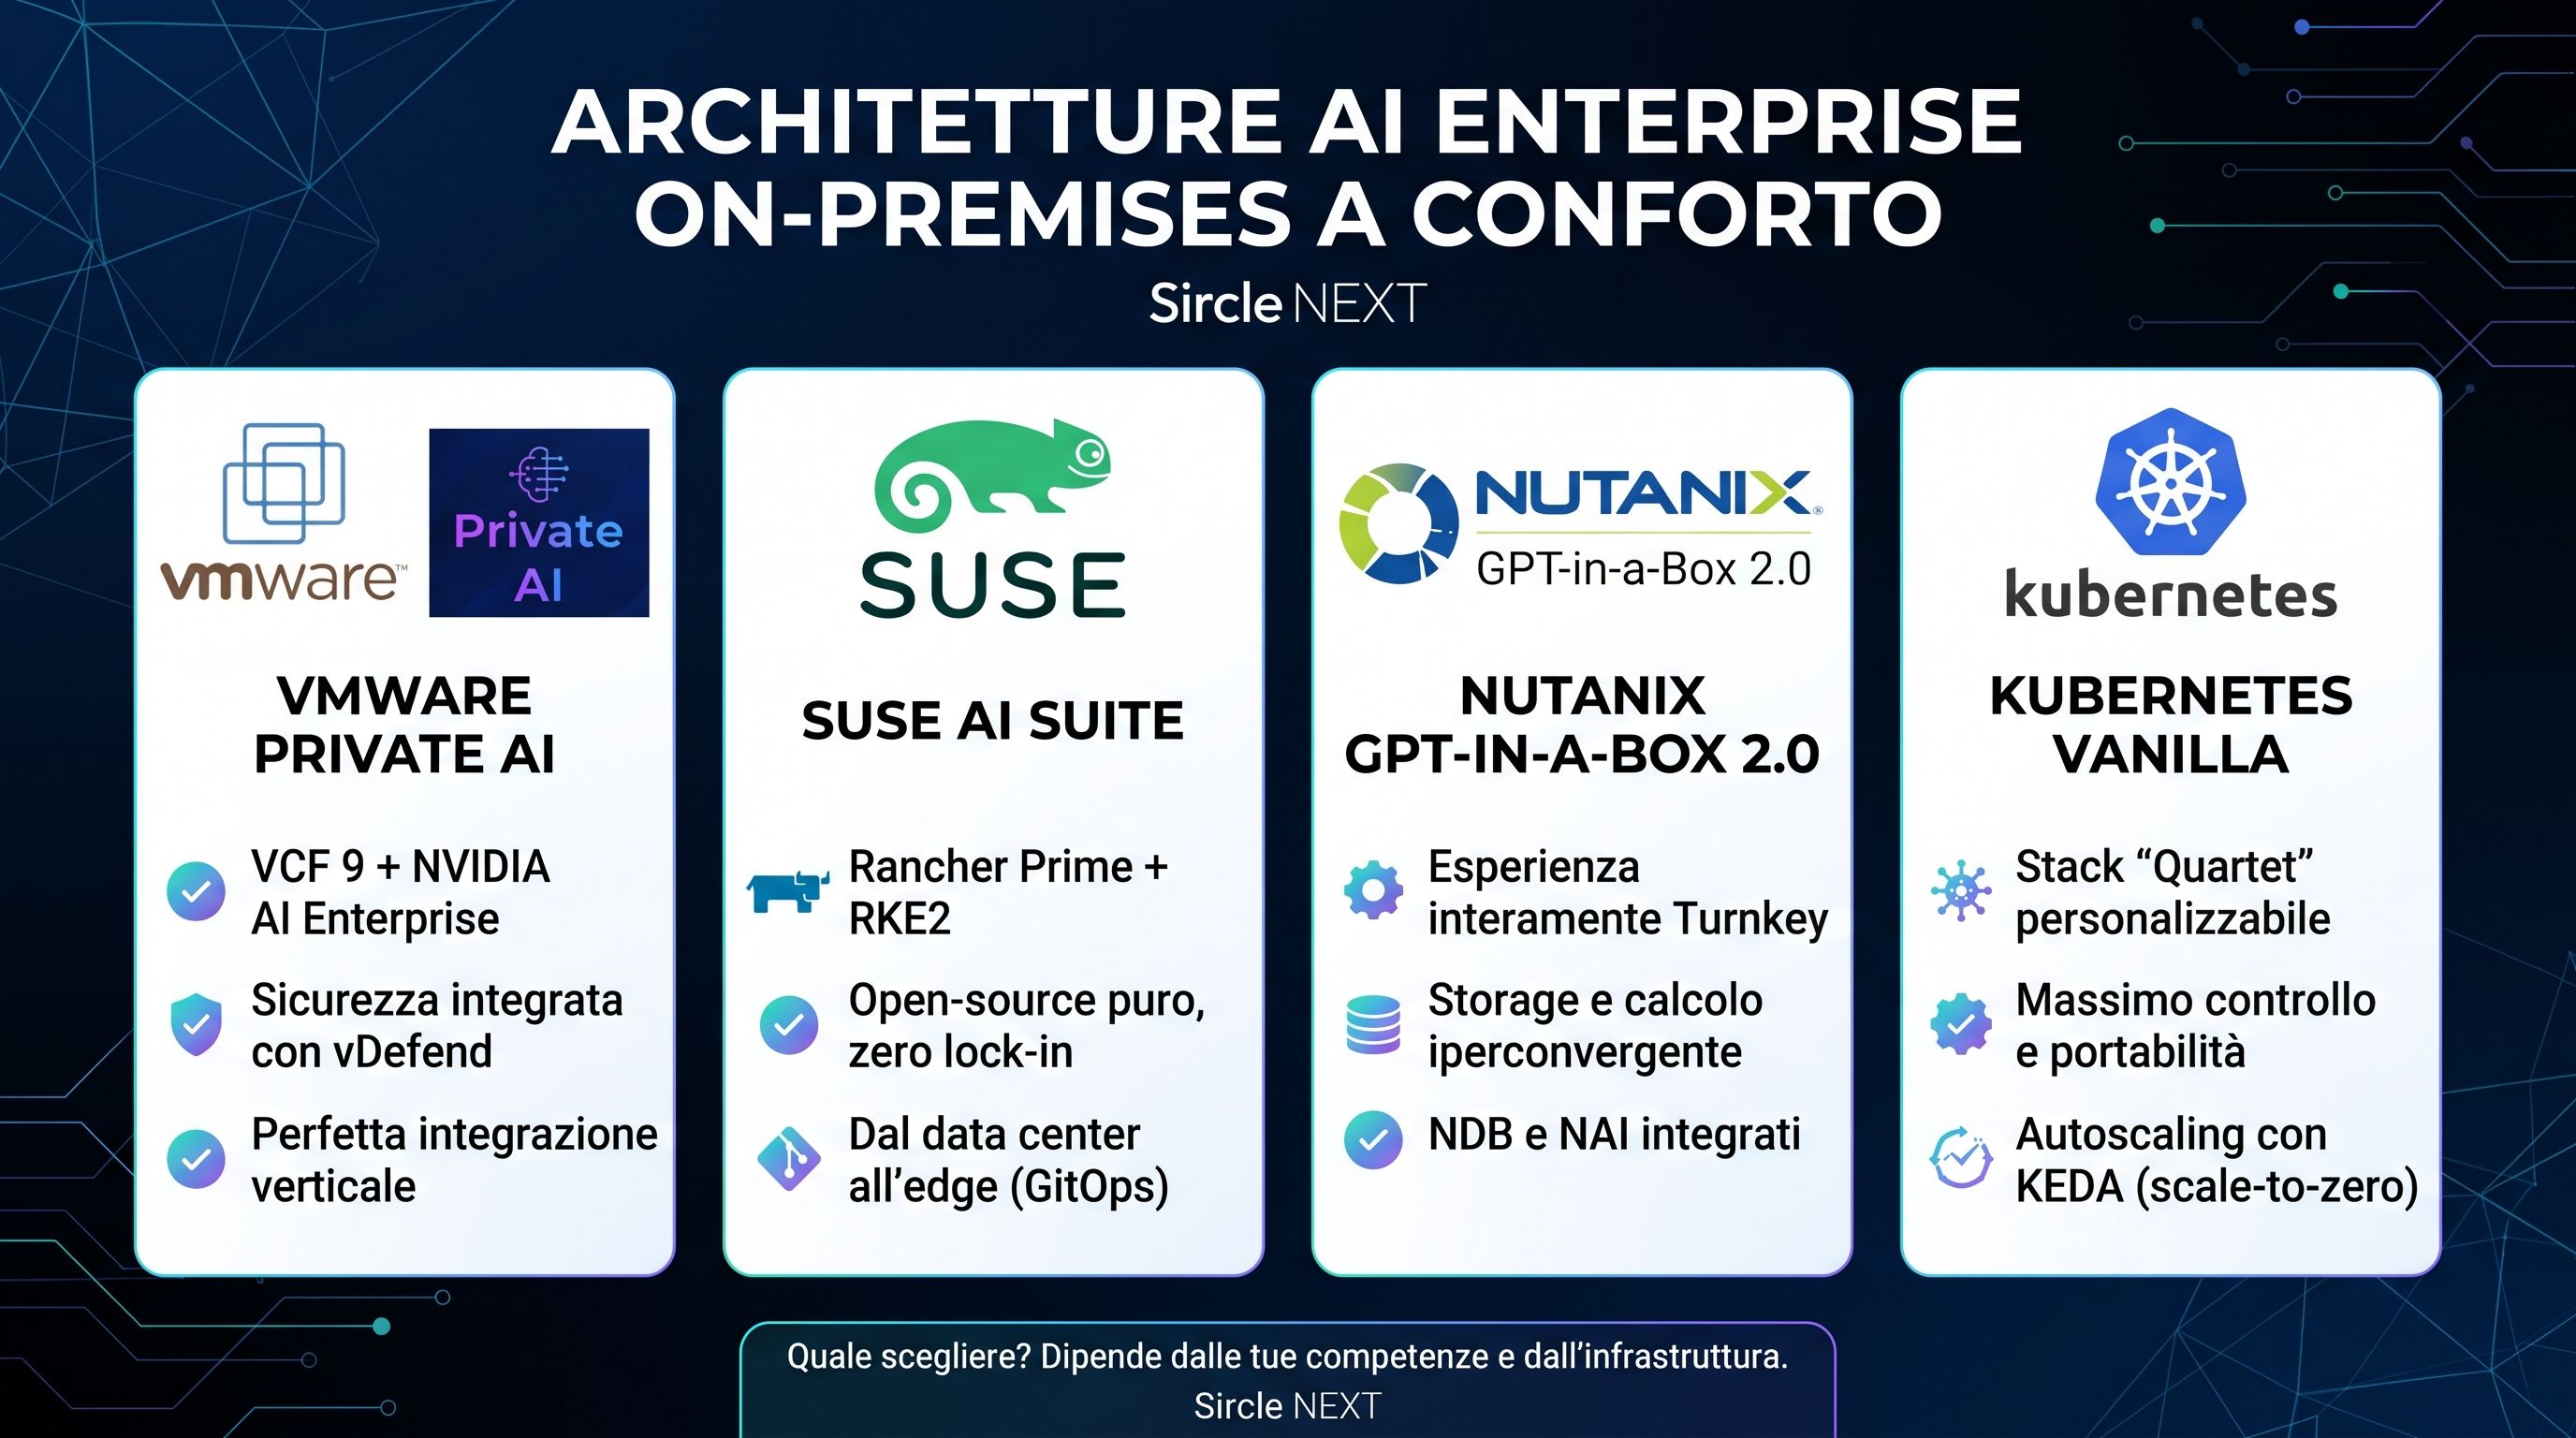
VMware Private AI: l'integrazione verticale
Il data center come roccaforte
VMware Private AI Foundation with NVIDIA unisce Broadcom VCF 9 e NVIDIA AI Enterprise. I servizi IA sono integrati nella piattaforma: Model Runtime (con Triton e vLLM), Data Indexing & Retrieval (con pgvector o Milvus) e Agent Builder.
Il punto di forza è la sicurezza. Con vDefend la micro-segmentazione arriva fino ai pod di VKS (vSphere Kubernetes Service). Frontend, database vettoriale e model server restano isolati, e il movimento laterale è contenuto anche se un pacchetto open-source viene compromesso.
Sul dimensionamento, l'architettura richiede almeno 3 host ESXi per cluster e scala fino a 64. Supporta GPU NVIDIA H100, L40S e Blackwell, ripartite con i profili vGPU.
SUSE AI Suite: apertura e flessibilità
Rancher Prime, dal data center all'edge
L'approccio di SUSE è puramente open-source e agnostico. Si basa su Rancher Prime con RKE2 (o K3s per l'edge) e include Ollama, Open WebUI e database vettoriali locali.
Due elementi lo distinguono:
- Liz, l'assistente di Rancher Prime, che dal 2026 funziona come architettura multi-agente. Un supervisor router smista le richieste ad agenti specializzati per GitOps, provisioning e sicurezza, e valida le risposte prima di inviarle.
- L'edge: con K3s e la distribuzione GitOps via Fleet si gestiscono migliaia di micro-nodi IA con un design minimale.
Per osservabilità e sicurezza ci sono la AI Observability Extension e NeuVector.
Nutanix GPT-in-a-Box 2.0: il turnkey
Storage, calcolo e inferenza in un'unica piattaforma
Nutanix punta sulla semplicità: un'infrastruttura iperconvergente su NKP (Nutanix Kubernetes Platform), con endpoint di inferenza enterprise (NAI) pronti all'uso.
Il percorso dei dati è corto:
- NDB fornisce PostgreSQL con pgvector per il retrieval;
- Nutanix Files ospita i documenti non strutturati, e Objects (bucket S3 locali) fa da cache per i pesi dei modelli;
- l'inferenza gira su server Cisco UCS con GPU NVIDIA L40S o H100.
Il Sizer 6.0.94, rilasciato a dicembre 2025, calcola VRAM, CPU e IOPS necessari. Così si evita il t-shirt sizing e, con esso, l'over-provisioning.
Kubernetes vanilla: lo stack "Quartet"
Il controllo totale, per i team di ingegneria
Chi ha competenze interne può costruire tutto con primitive CNCF. Lo stack "Quartet" combina quattro componenti:
- KServe, il control plane dell'inferenza;
- vLLM, con PagedAttention e continuous batching;
- llm-d, per il routing KV-cache-aware e la disaggregazione prefill-decode;
- WG Serving, per l'interoperabilità degli standard aperti.
Il vantaggio è l'autoscaling eterogeneo. I retriever scalano su CPU fino a 30 repliche, l'orchestrator resta tra 2 e 10 repliche, e i pod GPU scalano con KEDA fino allo scale-to-zero. Per un costo GPU come questo, non pagare le repliche inattive fa la differenza.
Come scegliere: quattro filosofie
Non esiste lo stack migliore in assoluto, esiste quello più adatto alla vostra organizzazione:
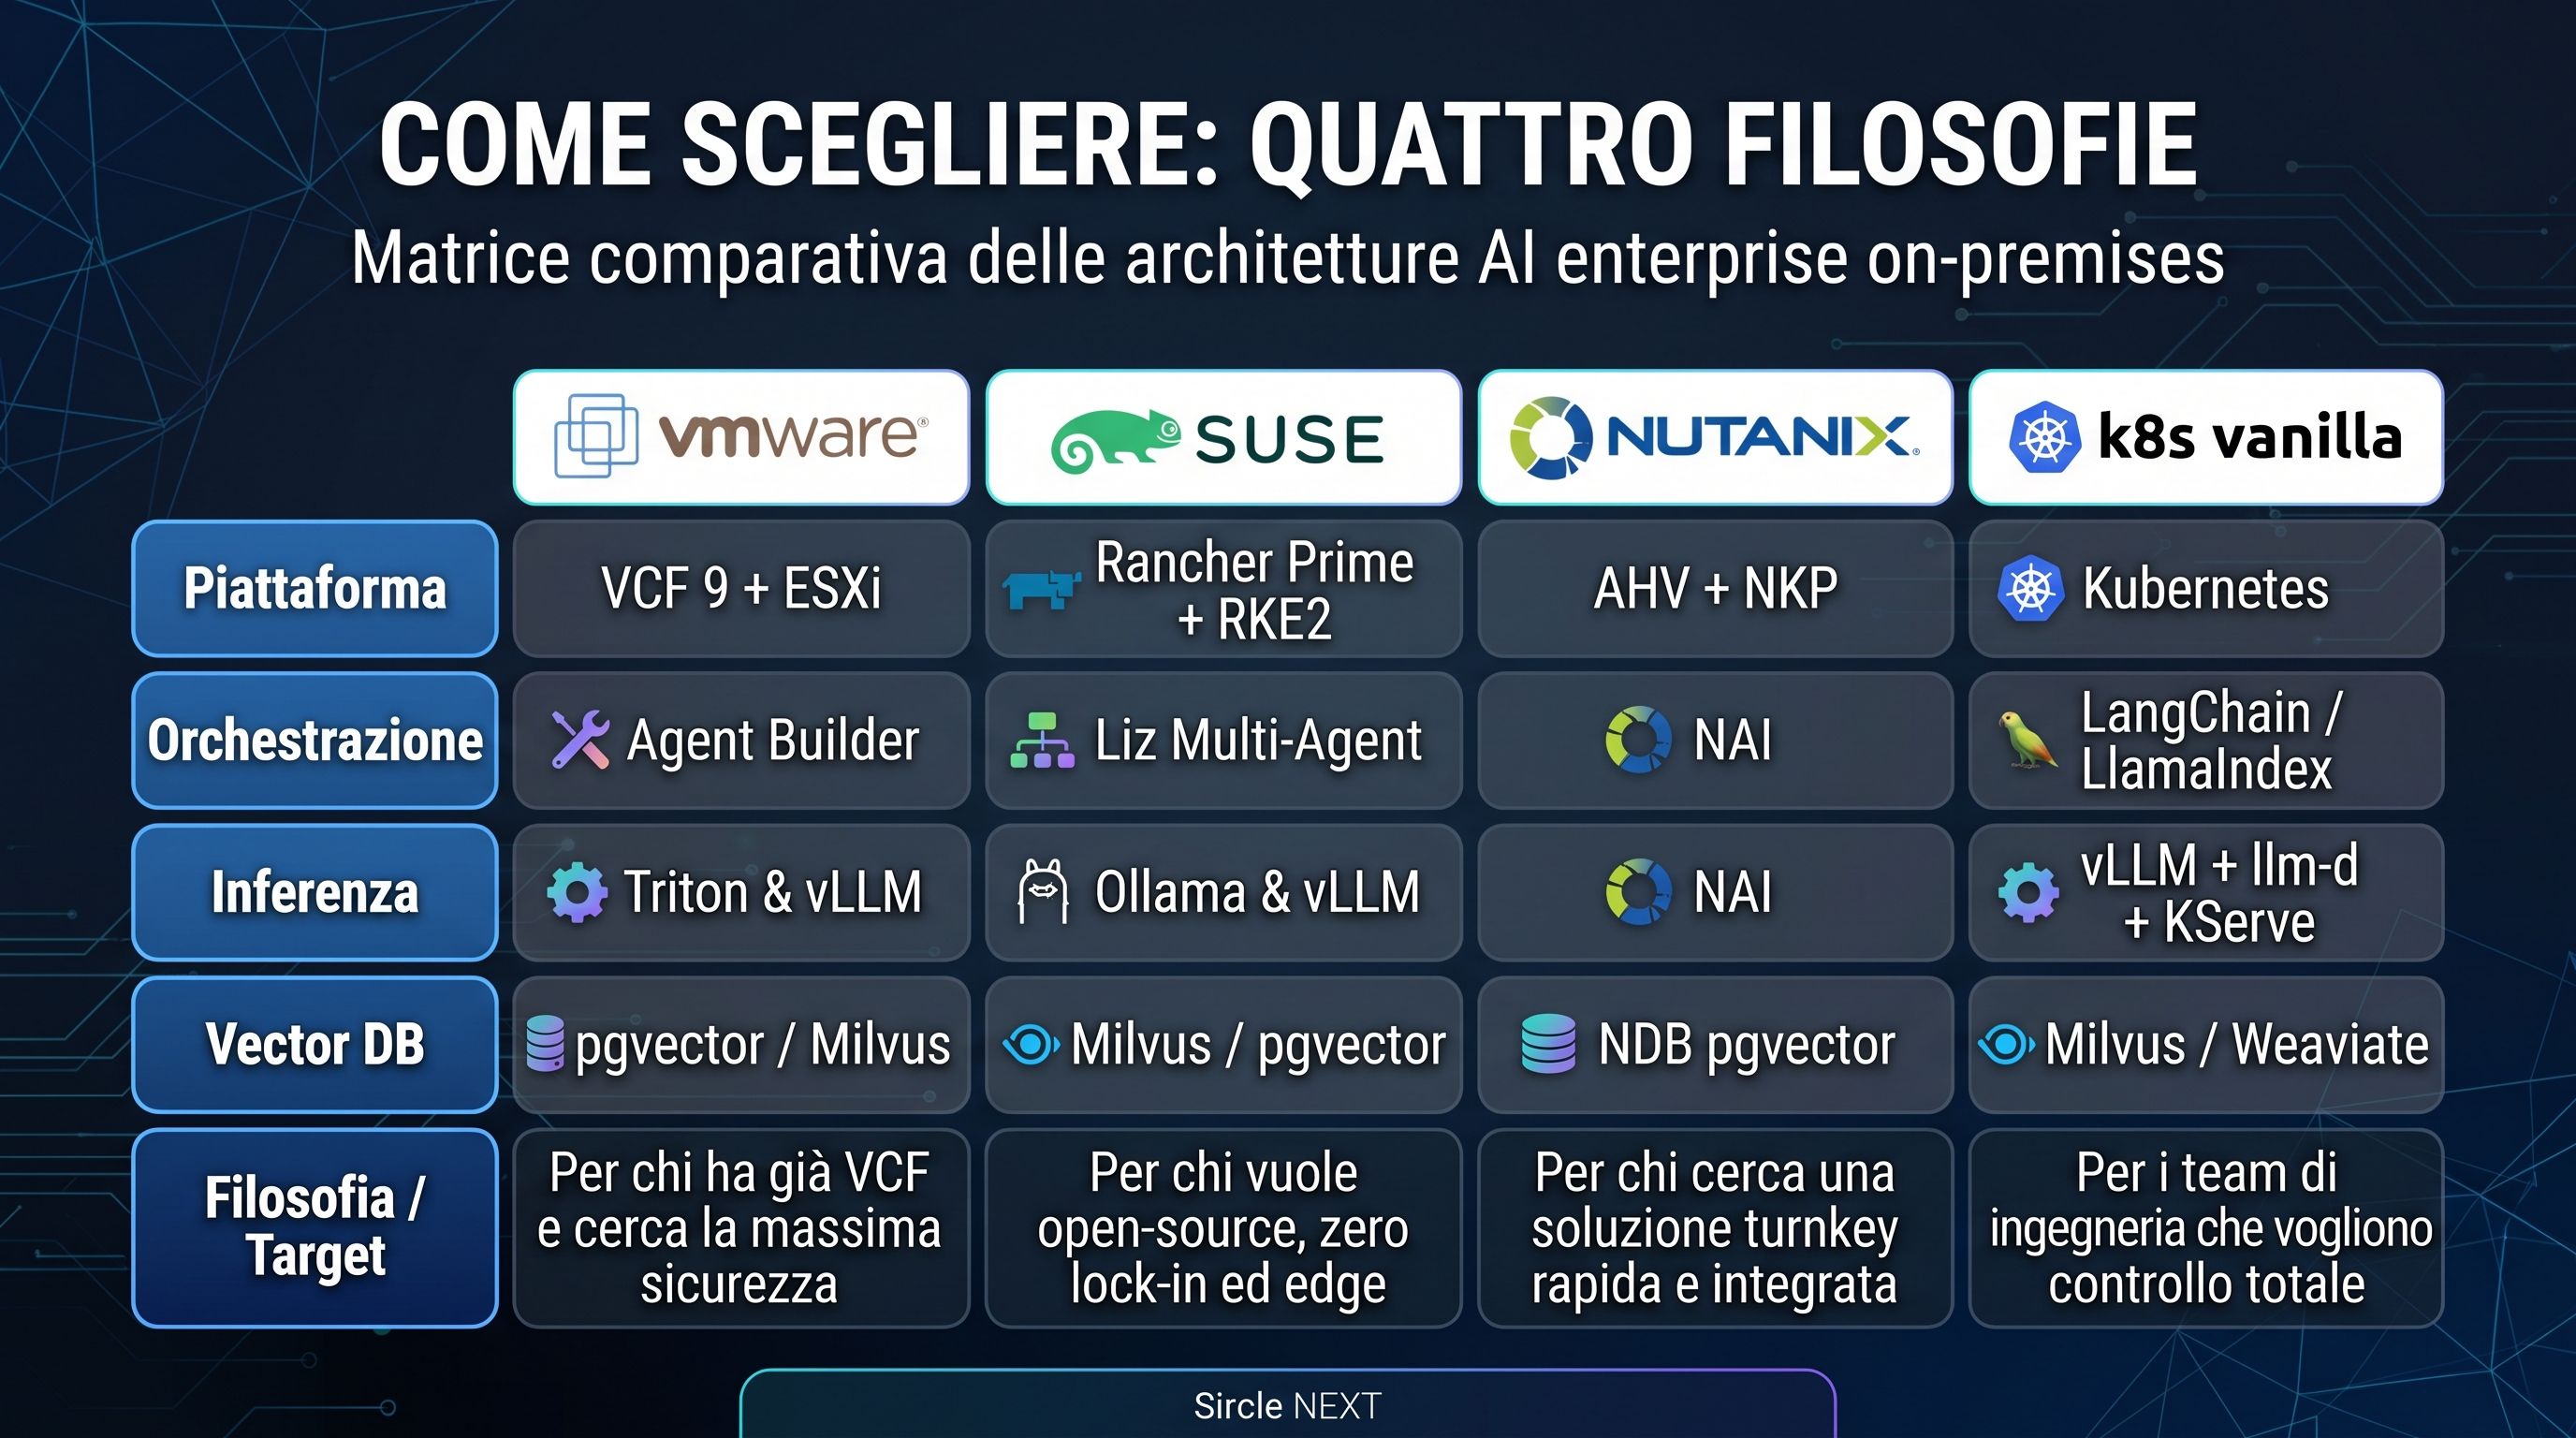
- VMware se l'infrastruttura è già VCF e la priorità è la sicurezza integrata;
- SUSE se contano apertura, assenza di lock-in ed edge;
- Nutanix se serve arrivare in produzione in fretta, con un'esperienza chiavi in mano;
- Kubernetes vanilla se il team di ingegneria vuole il massimo controllo e portabilità.
In Conclusione
Le quattro architetture portano la stessa promessa: l'intero ciclo dati, dal prompt all'inferenza, resta nel perimetro aziendale. Cambia il compromesso tra integrazione e controllo. Più lo stack è integrato, meno lavoro resta al cliente, ma anche meno libertà di personalizzare.
La scelta giusta dipende dalle competenze del team, dall'infrastruttura esistente e dal modello operativo che si vuole sostenere nel tempo.
Vuoi capire quale stack fa per te?
Contattaci per un confronto sul tuo caso d'uso a Sircle NEXT.